用好AI的第一步:停止和AI聊天
出处
来源:原网页
一句话结论
真正拉开 AI 使用效果差距的,不是你有没有打开 ChatGPT,而是你是否把 AI 放进了一个有反馈闭环、上下文充足、资产持续积累的工作系统里。
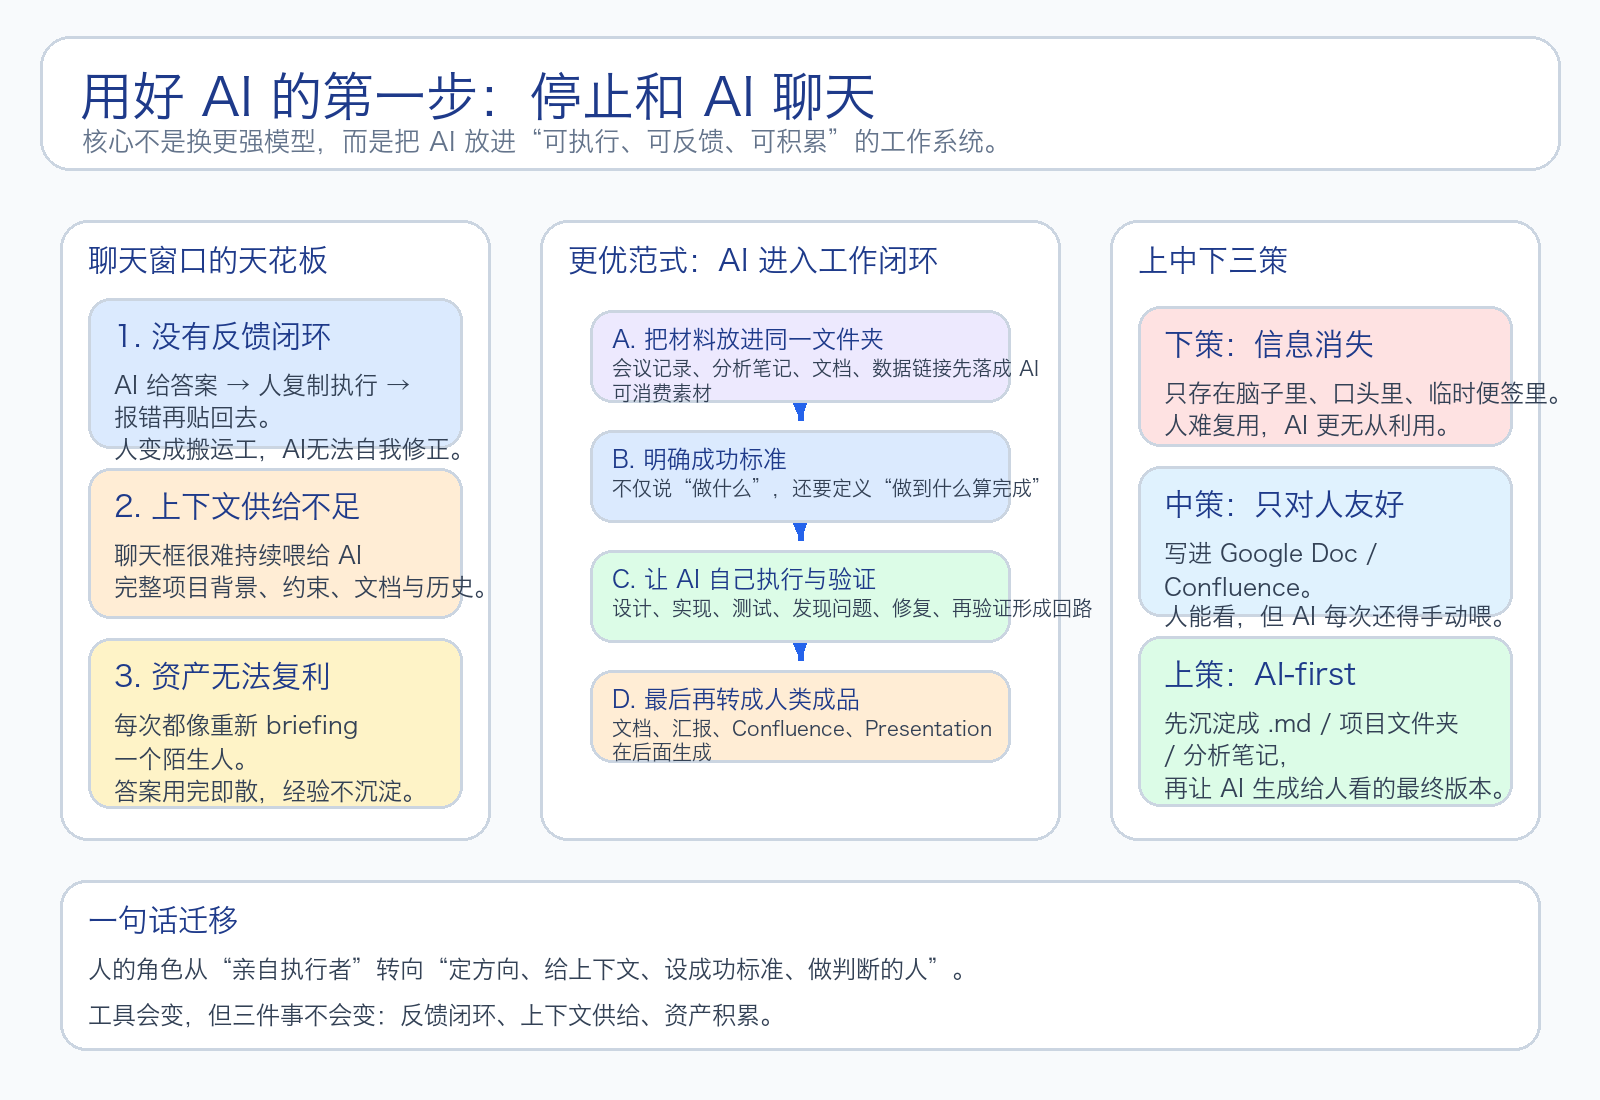
一张图看懂
核心观点
1. 聊天窗口只是 AI 的最低使用形态
作者认为,大多数人虽然已经高频使用 AI,但工作方式仍停留在“两年前的聊天模式”:
- 打开聊天窗口
- 提一个问题
- 等一个答案
- 人工拿着答案继续执行
这比完全不用 AI 好,但远远不是最优解。 问题不在于模型不够强,而在于这种用法天然把 AI 限制在“顾问”位置,而不是“执行者”位置。
2. 真正的效率差距来自三件事:反馈闭环、上下文供给、资产积累
作者把差距的来源拆成三层:
反馈闭环: ChatGPT 给出代码或建议后,人要手动复制、运行、报错、再贴回去。人类在中间充当“反馈搬运工”。而像 Cursor 这类工具接入执行环境后,AI 可以自己运行、自己看到报错、自己迭代修正。
上下文供给: AI 输出质量常常不是卡在“模型聪不聪明”,而是卡在“它是否看到了足够完整的背景”。聊天窗口难以持续、低摩擦地喂给 AI 项目上下文;而项目文件夹、文档引用、会议记录和分析笔记可以显著提升结果贴合度。
资产积累: 聊天式使用是一次性消费,答案用完就散;项目化使用是长期投资,文档、规则、笔记、目录结构都会逐渐沉淀成 AI 可复用资产,协作效率会持续复利。
3. Cursor 代表的不是“程序员版 ChatGPT”,而是新的 AI 工作接口
文章认为,Cursor、Claude Code、Codex 这类工具的重要性不只在写代码,而在于它们代表了一种新的 AI 使用方式:
- AI 不再只是回答问题
- AI 可以进入执行环境
- AI 可以围绕目标自己尝试、验证、修正
- 人的职责转成定方向、审结果、设边界
所以,它们并不只是“聊天框升级版”,而是把 AI 接进工作流本身的入口。
4. “上中下三策”是理解 AI 工作流升级的实用框架
作者提出一个很实用的分类:
下策:信息消失
- 会议开完就忘
- 想法停留在脑子里
- 失败案例只存在零散链接或临时备注里
中策:记录成人能看的形式
- 写 Google Doc
- 写 Confluence
- 做纪要、做说明
这已经比“什么都不留”好很多,但它主要对人友好,对 AI 仍不够顺滑。
上策:先让 AI 能消费,再加工给人看
- 把会议转录成
.md - 把分析笔记放进项目目录
- 把失败 case、观察、假设和约束沉淀到 AI 可直接引用的文件里
- 让 AI 先基于这些材料完成分析、实现、验证和文档草稿
- 最后再转成人类世界的展示版本
- 把会议转录成
这个框架的关键不只是“记下来”,而是优先用 AI 低摩擦可消费的形式保存信息。
5. Success criteria 是让 AI 真正跑起来的关键变量
文章里一个非常重要的点是: 很多人只告诉 AI “做什么”,却没有告诉它“做到什么算完成”。
如果没有终点线,AI 只能靠猜; 一旦成功标准明确,AI 才能围绕这个标准反复执行:
- 设计方案
- 实现修改
- 跑测试
- 发现问题
- 修复问题
- 再次验证
也就是说,成功标准不是补充信息,而是让 AI 进入闭环执行状态的前提条件。
6. 整个工作流应该从 human-first 转成 AI-first
传统工作流通常是:
- 人先整理、先写、先做
- AI 最后帮忙润色、补充、改写
作者主张反过来:
- 先把原始材料沉淀成 AI 友好的格式
- 让 AI 完成主要加工工作
- 最后再转换成人类协作系统里的结果物
例如:
- 先在项目目录存会议记录、分析笔记、数据链接
- 再让 AI 生成技术文档或汇报材料
- 最后把结果贴到 Confluence、PPT 或其他系统里
这个顺序看似只是流程调整,实质上改变了生产角色分工: AI 成为主要执行者,人类成为目标设定者与质量判断者。
7. 作者真正反对的不是 ChatGPT,而是“只会聊天”的工作习惯
文章标题虽然是“停止和 AI 聊天”,但更准确的理解是: 停止把 AI 仅仅当作聊天问答工具。
作者并不是说聊天没价值,而是说: 如果你的工作仍然围绕聊天窗口展开,你就很难获得 10 倍级别的生产力提升。 真正有效的方式,是让 AI 进入你的项目、材料、流程与验证机制里。
核心脉络
这篇文章的完整逻辑链条可以压缩成这样:
- 大多数人虽然在用 AI,但仍停留在问答模式
- 问答模式缺乏反馈闭环、上下文供给和资产沉淀
- 所以 AI 很难真正接管复杂工作的完整循环
- 一旦把会议记录、分析笔记、失败案例和目标标准放进统一工作目录
- AI 就可以在同一个上下文环境里持续执行、验证和修正
- 人类的角色也因此从“亲自做”转成“定方向、给标准、做判断”
对实际工作的启发
对个人知识工作者
- 不要把“会问 AI”误当成“会用 AI”
- 真正关键的是:你是否把材料整理成 AI 能持续消费的工作环境
- 即使不写代码,也可以把研究笔记、会议记录、采访素材、分析表格放进统一目录,让 AI 在这个环境中工作
对工程/产品/研究团队
- 项目文件夹应该成为 AI 协作的第一现场
- 会议记录、分析文档、假设、成功标准、反馈结果都应尽量写成结构化文件
- 不要只追求更强模型,而忽略工作材料是否可被 AI 高效读取和循环利用
对日常习惯改造
如果今天只做一个改变,最值得尝试的是:
- 选一个正在推进的项目
- 建一个统一文件夹
- 把相关文档、会议记录、分析笔记、案例材料都放进去
- 先不要习惯性打开聊天窗口
- 直接让能接入工作环境的 AI 工具围绕这些材料工作
你会感受到的差异,不只是“回答更聪明”,而是AI 开始真的替你推进工作。
我认为最值得记住的三句话
- 能用 AI 和用好 AI 之间,差的不是 30%,而可能是 10 倍。
- 反馈闭环、上下文供给、资产积累,才是 AI 生产力跃迁的底层来源。
- 人的角色不再是亲自执行每一步,而是定义方向、提供标准、做最终判断。
原文标记
- 原文标题:用好AI的第一步:停止和AI聊天
- 来源:yage.ai 文章页
- 原文核心不是否定 ChatGPT 本身,而是否定“把 AI 限制在聊天框里”的单一用法
- 文中大量例子以 Cursor 为载体,但其结论可推广到所有能进入执行环境、调用工具、消费项目上下文的 AI 工作方式