OpenClaw - The complete guide to building, training, and living with your personal AI agent
出处
来源:原网页
一句话结论
这篇文章真正讲清楚的,不是“怎么把 OpenClaw 装起来”,而是:只有把 OpenClaw 当成一套有岗位边界、权限边界、文件化记忆和持续执行机制的数字员工系统,它才会带来复利;否则它只是一个更贵、更容易失控的聊天工具。
一张图看懂
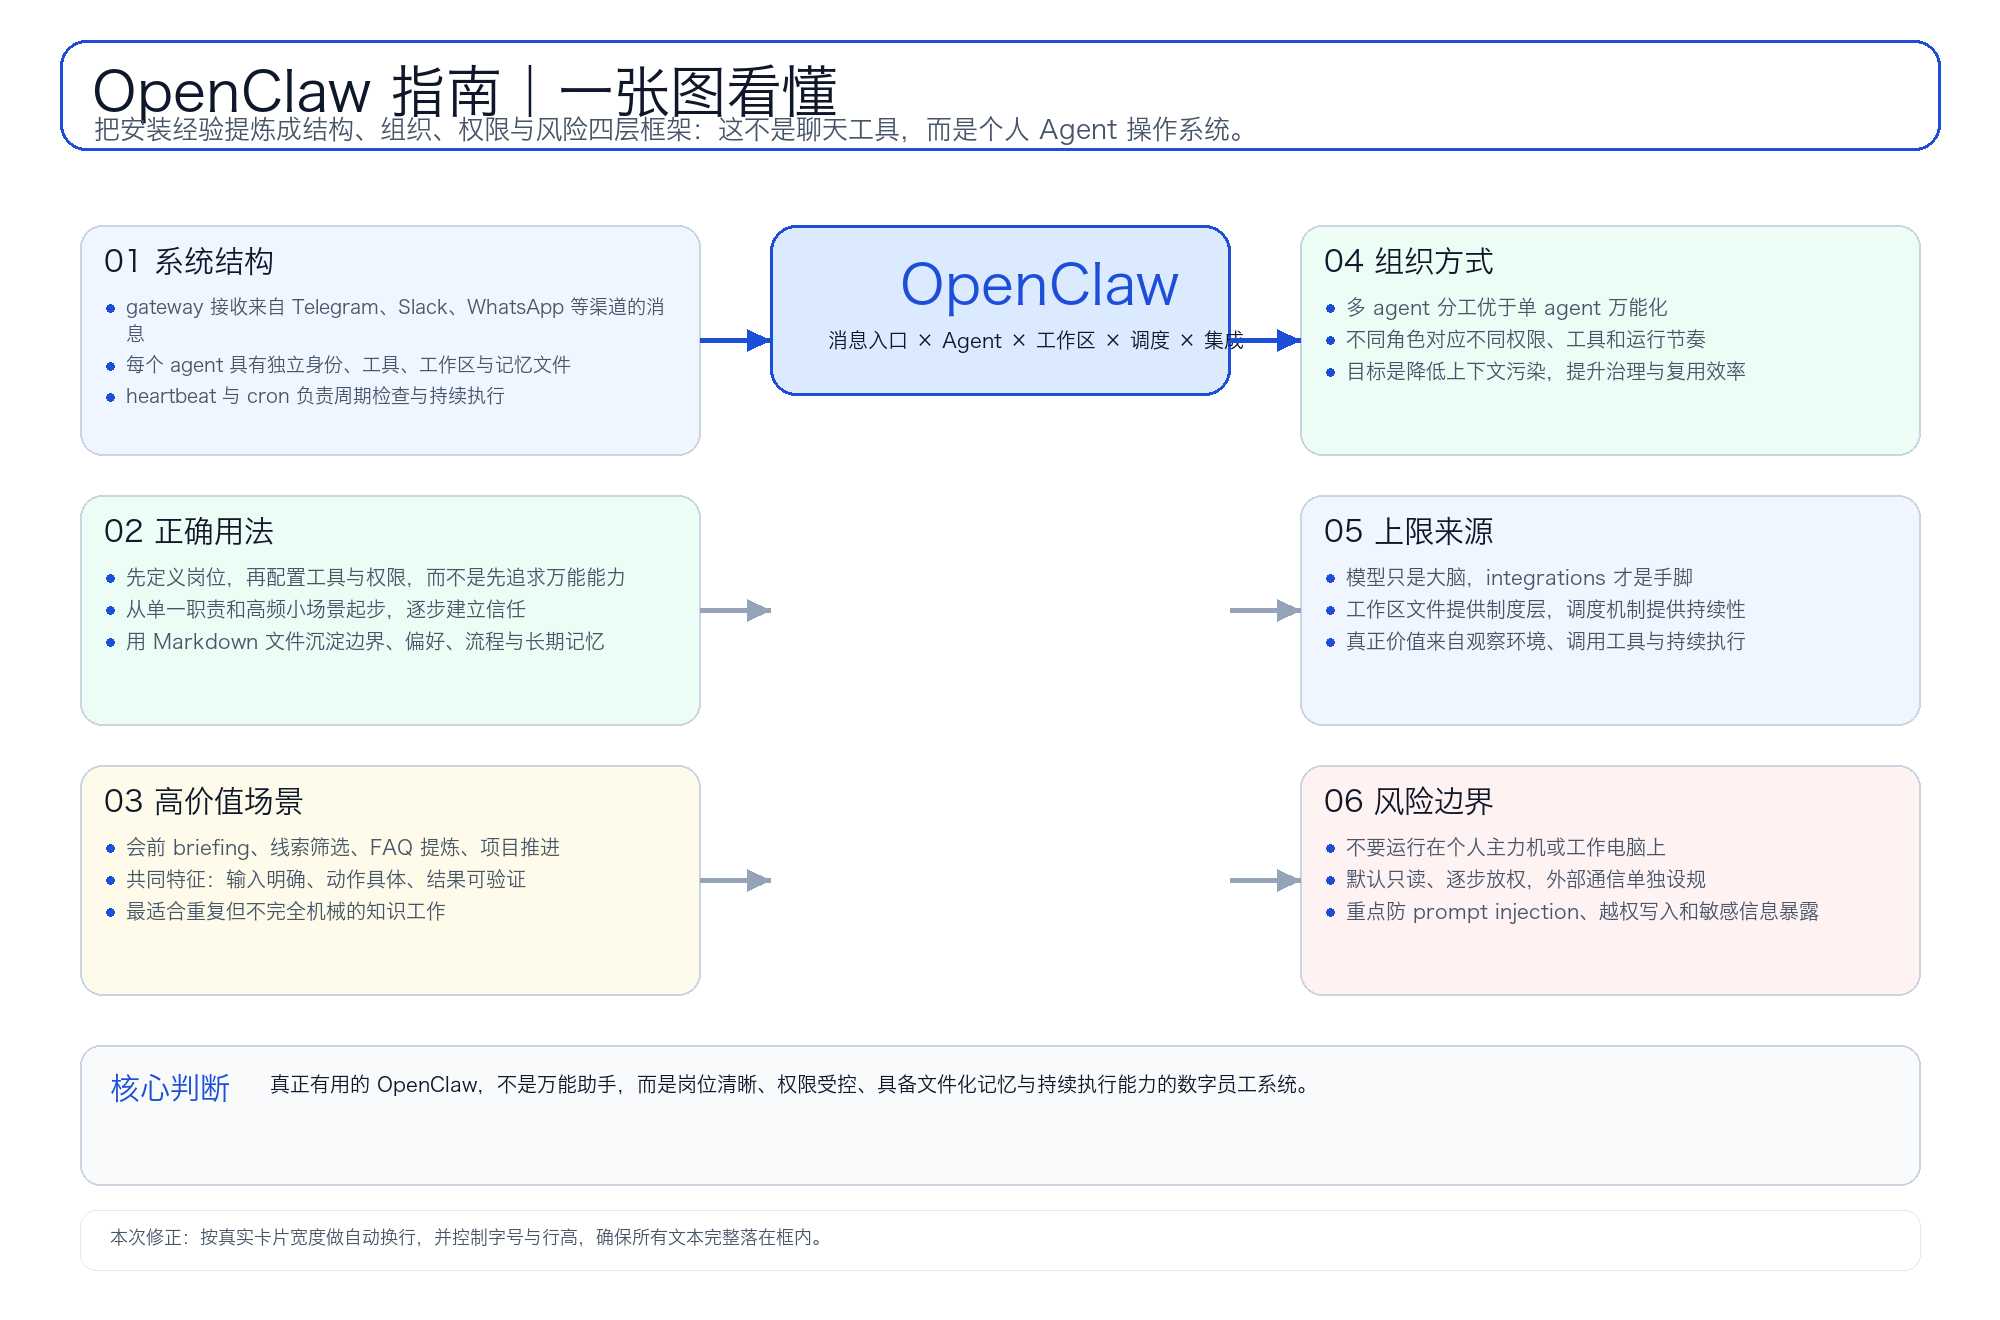
核心观点
1. OpenClaw 的价值不在“回答一次”,而在“持续负责一类事”
文章最关键的判断是:OpenClaw 不是单次对话增强器,而是可以把一句自然语言指令,转成一个会持续运行、周期检查、自动跟进的代理职责。
它之所以和普通聊天 AI 不一样,是因为它同时具备几层能力:
- 有稳定的消息入口,可以像给同事发消息一样派活
- 有 heartbeat 和 cron,可以把任务变成持续职责而不是一次执行
- 有独立工作区,可以沉淀身份、规则、记忆和运行环境
- 能接入外部工具与系统,真正产生动作而不是只生成文字
所以文章真正想强调的是:OpenClaw 不是“更强的聊天框”,而是“你可以长期管理的一组数字员工”。
2. 最有效的组织方式不是万能 agent,而是多 agent 分工
作者反复强调,多 agent 不是炫技,而是 OpenClaw 从“好玩”走向“有生产力”的分界线。
原因很现实:
- 一个 agent 兼顾太多任务时,角色会漂移
- 上下文、记忆和目标容易互相污染
- 权限范围会越来越宽,风险也会一起放大
- 输出质量会随任务切换而变得不稳定
作者分享的实践,本质上是在搭一支数字团队:
- 个人助理 agent
- 家庭协调 agent
- 市场内容 agent
- 销售 agent
- 客服 agent
- 课程运营 agent
- 播客制作 agent
- 开发 agent
- 教育/答疑 agent
其背后的方法论很重要:agent 更适合被设计成“岗位”,而不是“万能模型入口”。
3. OpenClaw 的核心不是模型,而是“消息 + 工作区 + 调度 + 集成”四件套
文章其实把 OpenClaw 的系统结构讲得很清楚:
- 消息入口:Telegram、Slack、WhatsApp 等,让交互足够自然
- agent 工作区:通过
AGENTS.md、SOUL.md、TOOLS.md、USER.md、MEMORY.md约束长期行为 - 调度机制:heartbeat 和 cron,让请求从临时对话变成持续执行
- 外部集成:邮件、搜索、GitHub、知识库、任务系统等,决定它是否真的能行动
这意味着 OpenClaw 的核心价值从来不是“模型会不会说”,而是: 它能不能在明确边界下观察环境、调用工具、沉淀记忆、持续执行。
4. 这篇文章本质上也是一份权限设计指南
表面上它是安装教程,实际上作者一直在讲安全边界。
她最强烈的建议包括:
- 不要直接安装在个人主力机或工作电脑上
- 从隔离环境开始,例如 VPS、托管方案、旧电脑、Mac mini
- 默认先给只读权限
- 不要轻易开放对外发信、删改文档、写入生产系统的能力
- 不要把 agent 随便放进公开群聊
- 把通信规则和危险边界明确写进工作区文件
这背后有一个很重要的认知转换: 一旦 OpenClaw 接入真实系统,它就不再只是“AI 会不会答错”,而是“一个自动化执行者会不会越权、误操作或被诱导行动”。
5. 让 agent 变稳定的,不是更多 prompt,而是更好的文件化制度
文章里一个非常值得保留的点是:OpenClaw 的长期行为不是只靠聊天上下文,而是靠一组 Markdown 文件塑造。
这些文件分别承担现实中的角色:
- 岗位说明书
- 人格与边界约束
- 用户档案
- 工具和环境说明
- 长短期记忆
这意味着你不是在一次次“重写提示词”,而是在逐步建立一个可读、可改、可审计的代理操作系统。
对长期使用来说,这种“文件即制度”的设计,比 prompt engineering 更有复利。
6. 真正让 OpenClaw 像员工一样工作的,是 integrations
作者明确说,如果没有 integrations,OpenClaw 很容易沦为“更难安装的本地 AI 工具”。
一旦接入外部系统,才会真正出现行动能力:
- Gmail / Calendar / Docs 让它进入日常工作流
- GitHub / Linear 让它进入研发和执行流
- 搜索工具让它具备外部观察能力
- Obsidian 让它具备共享知识空间
所以可以把文章里的隐含结论概括成一句: 模型只是大脑,集成才是手脚,调度是作息,Markdown 文件是制度。
7. 最适合起步的场景,是高频、边界清晰、结果易验证的任务
文中虽然给了很多案例,但它们其实有共同结构:
- 输入源清晰
- 任务边界明确
- 输出动作具体
- 成功与失败容易判断
- 可以周期性重复
比如:
- 会前 30 分钟自动发 briefing
- 每天扫描线索并分层处理
- 每周提炼客服 FAQ 候选
- 每天生成营销素材供人工审批
- 持续维护项目待办并按天推进
这对实际落地非常重要,因为它说明: 最适合 agent 的,不是开放式空泛任务,而是半结构化、重复性高、闭环明确的知识工作。
8. 安全不是附录,而是全文最该长期记住的部分
作者对风险的提醒很具体,尤其包括:
- prompt injection
- 越权读取与写入
- 借邮件/API 对外发言或冒充用户
- 公共群聊中的误触发
- API key 和环境变量泄漏
- 安装来源不明的 skills
她真正提醒读者的是: 一旦 agent 拥有读网页、读邮件、执行命令、发消息、改文件的能力,它面对的就是现实世界的攻击面,而不再只是“回答是否准确”。
因此,最小权限、隔离部署、可信技能来源、明确通信规则,应该是默认配置,而不是后补动作。
核心脉络
一、先重新定义 OpenClaw:不是问答工具,而是常驻代理
作者先用自己已经在日常生活与工作中使用 OpenClaw 的经验,说明它更像一个常驻团队成员,而不是一次性助手。
二、再解释系统结构:消息入口、多个 agent、工作区文件、cron 与 heartbeat
这一步是为了让读者理解:为什么它可以从一句话延展成长期工作流。
三、然后给出部署原则:先隔离,再开放能力
文章并没有把重点放在安装命令本身,而是持续强调部署环境与权限设计。
四、接着进入 onboarding:模型、消息渠道、skills、文件化配置
这部分是在告诉读者,agent 是如何被“塑形”的。
五、再推进到实践:从单岗位切入,再走向多 agent 协作
这是全文最关键的转折,也是最有方法论价值的一段。
六、最后以 integrations 与安全收束
一边说明外部接入决定价值上限,一边说明安全边界决定你能否放心长期运行。
对实际工作的启发
1. 如果要在团队中引入 agent,先设计组织结构,再设计提示词
真正决定效果的往往不是 prompt,而是:
- 岗位是否清晰
- 输入输出是否稳定
- 工具是否匹配职责
- 权限是否足够小而清楚
2. Markdown-native 的工作区很适合做人机共用操作系统
这篇文章特别适合拿来反思:为什么很多 AI 系统一旦离开聊天窗口就很难长期稳定。
原因之一就是缺少可读、可改、可审计的制度层。OpenClaw 用 Markdown 文件承接这层制度,反而更适合长期协作。
3. 多 agent 不是炫技,而是控制复杂度的工程方法
单 agent 常见的问题是:
- 上下文污染
- 目标冲突
- 权限过宽
- 记忆混杂
拆分后,反而更容易治理、调试和审计。
4. 真正高价值的 agent 任务,通常都是“重复但不完全机械”的工作
也就是那些:
- 需要一点理解
- 需要上下文
- 有规律发生
- 值得自动化
- 但又不适合写死规则引擎
这正是知识工作里最容易被 agent 放大的区域。
5. 评估 agent 价值,应该看杠杆,而不是看它是否零失误
作者的态度非常现实:它会出错,会忘事,会跑偏,但仍然值得投入,因为它能持续放大产能。
这个判断很重要。把 agent 当成“零失误自动驾驶”会失望;把它当成“需要管理但能持续产出的数字员工”,反而更接近正确预期。
我认为最值得记住的三句话
- OpenClaw 的真正价值,不是一次回答问题,而是把一句话变成可持续执行的职责。
- 好用的 agent 系统不是万能 bot,而是一组岗位清晰、权限可控、彼此协作的数字员工。
- 决定 OpenClaw 上限的不是模型本身,而是你的角色设计、权限设计、集成能力和安全边界。
原文标记
- 作者:Claire Vo
- 出处:Lenny’s Newsletter
- 标题:OpenClaw: The complete guide to building, training, and living with your personal AI agent
- 形式:经验总结 + 安装指南 + 多 agent 实战方法论
- 语言:英文原文;本文为中文提炼与重写
- 说明:本版按 AI-Notes 当前硬规则重做,
一张图看懂已改为 PNG 插图嵌入 - 链接:https://www.lennysnewsletter.com/p/openclaw-the-complete-guide-to-building