Harness Engineering:当工程师不再写代码
出处
来源:原网页
一句话结论
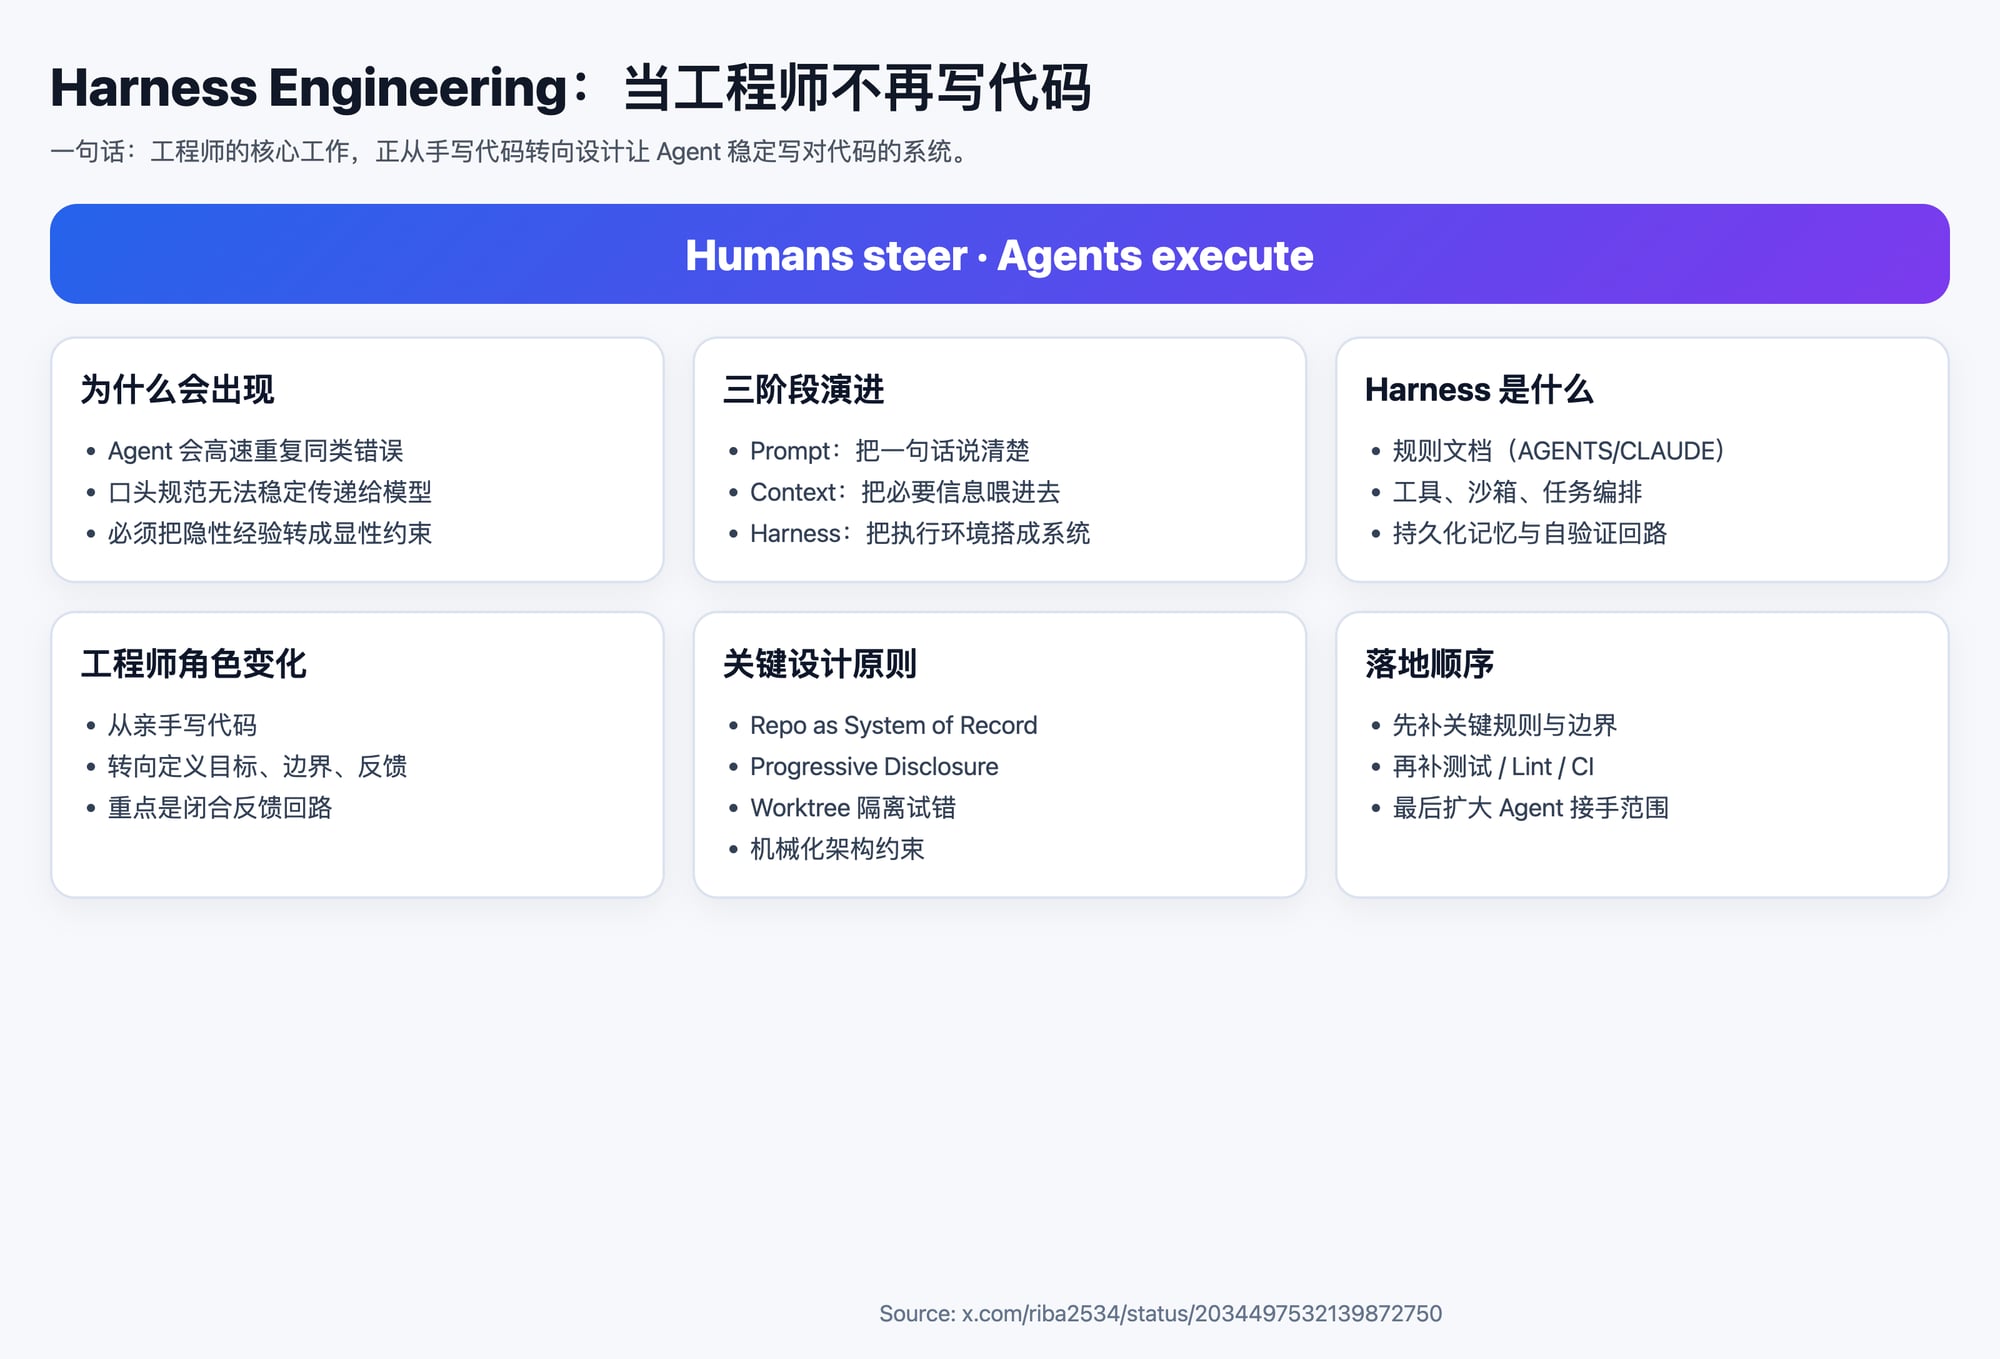
AI 时代工程师的核心产出,正在从“亲手写代码”转向“设计一套让 Agent 稳定写对代码的执行系统”。
一张图看懂
核心观点
1. 写规则不是额外成本,而是工作本体
作者最初觉得不断补 CLAUDE.md 很浪费时间:
- Agent 犯错一次,就要补一条规则
- 上下文、约束、禁区越写越多
- 文档逐渐膨胀成几百行
后来他意识到,这不是“为写代码做准备”,而是新的工程工作本身: 把隐性经验、架构纪律、质量标准,转成机器可执行的环境约束。
2. 真正的瓶颈不是模型会不会写,而是环境是否可执行
文中引用 OpenAI 的实验:
- 3 个工程师
- 5 个月
- 用 Codex Agent 从空仓库做出超过 100 万行代码的产品
- 合并约 1500 个 PR
- 代码基本全部由 Agent 生成
关键问题不在“Agent 能不能生成代码”,而在:
- 是否知道依赖边界
- 是否理解架构约束
- 是否能自行验证结果
- 是否能在失败后自动回路修正
也就是说,缺的不是代码生成能力,而是能让生成结果持续收敛的反馈系统。
3. Prompt Engineering 已经不够了,重点转向 Harness Engineering
作者把演进分成三阶段:
- Prompt Engineering:把一句话说清楚
- Context Engineering:把必要信息喂进去
- Harness Engineering:把整个执行环境搭成可持续运转的系统
最核心的变化是: 以前优化的是“这次回答”; 现在优化的是“这套系统能不能长期稳定地产出正确结果”。
4. Harness = 模型之外的一切执行基础设施
文中借用了一个常见定义: Agent = Model + Harness
Harness 包括:
- system prompt
- 仓库内规则文档(如 AGENTS.md / CLAUDE.md)
- 工具定义
- 执行沙箱
- hooks / middleware
- 任务编排
- 持久化记忆
- 自验证与反馈回路
模型像引擎,Harness 像整辆车。 引擎再强,没有刹车、导航、仪表盘和路况反馈,也无法稳定上生产。
5. 工程师角色转移:从直接执行到闭合反馈回路
文章把 Harness Engineering 放进“控制论”脉络里看,给了一个很有力的类比:
- 蒸汽机时代:工人手动调阀门,后来变成设计调速器
- Kubernetes 时代:工程师不再手动 SSH 修服务,而是声明目标状态,由控制器持续校正
- Agent 时代:工程师不再逐行写代码,而是设计让 Agent 自动生成、自动验证、自动修正的系统
核心转变是: 人负责设定目标、边界和反馈;Agent 负责具体执行。
6. 好的 Harness 依赖“机械化约束”,而不是口头约定
文中反复强调一个点: 不要把规范留在 Slack、口头沟通或 code review 习惯里。 应该尽量变成机械可执行的约束:
- 依赖方向写成 linter 规则
- 架构边界写进 CI
- 质量标准变成 golden principles
- 测试、类型检查、浏览器验证嵌入 Agent 执行循环
一句话: 人能理解的规范不够,Agent 必须能执行。
7. “Repo as System of Record” 会越来越重要
高频出现的设计模式包括:
- 文档按需加载,而不是一次性全部塞进上下文
- 每个 Agent 在独立 worktree 中试错
- 任务定义、架构边界、质量标准全部进仓库
- 用 CI / Linter / Tests 作为即时反馈回路
这背后的共同原则是: 仓库不是代码存放地,而是 Agent 工作时的唯一真理来源。
8. 模型能力会继续提升,但 Harness 不会消失
文章也提到行业分歧:
- 一派认为应建设更重的 Harness
- 一派认为应该尽量信任更强的模型,包装层保持轻量
作者的判断比较稳健: 模型变强,会替代一部分今天“不得不加”的脚手架; 但验证、约束、反馈这些需求不会消失。
也就是说,Harness 的具体形态会变,但“让系统稳定收敛”的工作不会消失。
核心脉络
这篇文章真正想说明的链路
- Agent 已经具备了大规模生成代码的能力
- 但它天然不知道团队规则、架构边界和质量标准
- 所以必须把这些隐性知识外显化、结构化、机械化
- 一旦测试、Linter、可观测性、任务拆解和规则文档构成闭环
- 工程师的主工作就从“手写代码”转成“设计系统,使代码被正确写出来”
对实际工作的启发
对个人/小团队
- 不要只追求“哪个 Agent 更强”,先把仓库里的规则写清楚
- 把常见错误沉淀成 Agent 可读文档,而不是每次口头纠正
- 把可自动验证的规范尽量变成脚本、测试、CI 和 lint 规则
- 给 Agent 提供低成本试错环境,例如独立 worktree、隔离沙箱
对存量项目
如果是多年老项目,先别幻想“一步 AI-native”。更现实的顺序是:
- 先补最关键的架构边界文档
- 再补最关键的自动化检查
- 再让 Agent 接手低风险、高验证性的任务
否则 Agent 只是以更快速度复制原有混乱。
对工程师自身定位
未来更值钱的能力,不只是“写得快”,而是:
- 能定义任务边界
- 能抽象规范
- 能搭反馈闭环
- 能把团队经验转成可执行系统
这会比“某个具体模型的提示词技巧”更耐久。
我认为最值得记住的三句话
- Humans steer. Agents execute.
- Agent = Model + Harness
- 写 CLAUDE.md,不是辅助工作,而是工程工作本身。
原文标记
这不是单篇正式长文,而是一条 X 长帖/线程式文章整理。正文综合了作者对 OpenAI《Harness Engineering》、控制论类比,以及多篇二手分析文章的吸收与再表达。